18 дек. 2025 г.·6 мин
Планирование фоновых задач без проблем с cron: шаблоны
Узнайте паттерны планирования фоновых задач с помощью workflow и таблицы jobs, чтобы надёжно запускать напоминания, ежедневные сводки и очистку.
Почему cron кажется простым, пока это не начинает ломаться
Cron хорош в первый день: напиши строку, выбери время, забудь. Для одного сервера и одной задачи это часто работает.
Проблемы проявляются, когда вы полагаетесь на планирование для реального поведения продукта: напоминания, ежедневные сводки, очистка или задания синхронизации. Большинство историй о «пропущенном запуске» — не про сбой cron. Это всё вокруг него: перезагрузка сервера, деплой, который перезаписал crontab, задача, которая работала дольше ожидаемого, или рассинхронизация часов и часовых зон. А когда у вас несколько инстансов приложения, появляется противоположная ошибка: дубли, потому что две машины думают, что должны выполнить одну и ту же задачу.
Тестирование — ещё одна слабая сторона. Строка cron не даёт простого способа воспроизвести «что случится завтра в 9:00» в повторяемом тесте. В результате планирование превращается в ручные проверки, сюрпризы в проде и охоту по логам.
Перед выбором подхода чётко определите, что вы планируете. Большая часть фоновой работы укладывается в несколько категорий:
- Напоминания (отправить в конкретное время, только один раз)
- Ежедневные сводки (агрегировать данные, затем отправить)
- Задачи очистки (удалять, архивировать, истекать)
- Периодические синхронизации (подтянуть или отправить обновления)
Иногда можно вообще обойтись без планирования. Если действие может происходить сразу при событии (пользователь зарегистрировался, платеж прошёл, тикет сменил статус), событие-ориентированная логика обычно проще и надёжнее, чем время-ориентированная.
Когда время всё же нужно, надёжность сводится к видимости и контролю. Нужно место, куда записывать, что должно выполняться, что выполнилось и что провалилось, а также безопасный способ повторить без создания дубликатов.
Базовый паттерн: планировщик, таблица задач, воркер
Простой способ избежать проблем с cron — разделить обязанности:
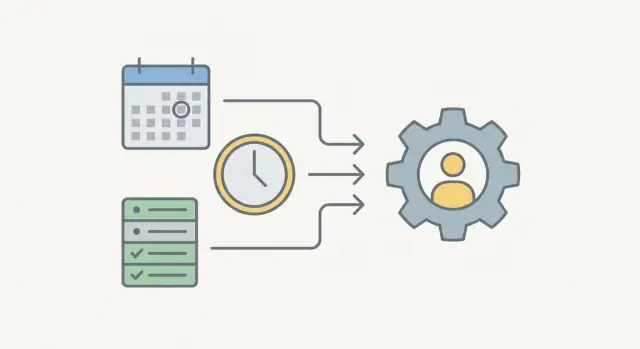
- Планировщик решает, что и когда должно выполниться.
- Воркер выполняет работу.
Разделение ролей помогает в двух вещах. Вы можете менять расписание, не трогая бизнес-логику, и менять бизнес-логику, не ломая расписание.
Таблица jobs становится источником правды. Вместо того чтобы прятать состояние внутри процесса сервера или строки crontab, каждая единица работы — это строка: что делать, для кого, когда запускать и что произошло в прошлый раз. Когда что‑то идёт не так, вы можете это посмотреть, повторить или отменить без догадок.
Типичный поток выглядит так:
- Планировщик сканирует просроченные задания (например,
run_at <= now и status = queued).
- Он захватывает задание, чтобы только один воркер его выполнил.
- Воркер читает детали задания и выполняет действие.
- Воркер записывает результат обратно в ту же строку.
Ключевая идея — делать работу возобновляемой, а не магической. Если воркер падает на середине, строка задания всё равно должна показывать, что произошло и что делать дальше.
Проектирование таблицы jobs, которая остаётся полезной
Таблица jobs должна быстро отвечать на два вопроса: что нужно запустить дальше и что случилось в прошлый раз.
Начните с небольшого набора полей, покрывающих идентичность, время и прогресс:
- id, type: уникальный id и короткий тип, например
send_reminder или daily_summary.
- payload: валидный JSON только с тем, что нужно воркеру (например
user_id, а не весь объект пользователя).
- run_at: когда задание становится допустимым к выполнению.
- status:
queued, running, succeeded, failed, canceled.
- attempts: увеличивается при каждой попытке.
Добавьте несколько операционных колонок, которые делают конкуренцию безопасной и инциденты проще разбирать. locked_at, locked_by и locked_until позволяют одному воркеру заявить задачу, чтобы её не выполнил кто‑то ещё. last_error должен быть коротким сообщением (и опционально кодом ошибки), а не дампом полного стек‑трейса, который раздувает строки.
И наконец, храните временные метки для поддержки и отчётности: created_at, updated_at и finished_at. Они позволяют ответить на вопросы вроде «Сколько напоминаний упало сегодня?» без копания в логах.
Индексы важны, потому что система постоянно спрашивает «что дальше?» Два индекса обычно окупаются:
(status, run_at) для быстрого поиска просроченных задач(type, status) чтобы инспектировать или приостановить класс задач при проблемах
Для payload предпочитайте маленький, сфокусированный JSON и валидируйте его перед вставкой задачи. Храните идентификаторы и параметры, а не снимки бизнес‑данных. Относитесь к форме payload как к контракту API, чтобы старые поставленные в очередь задания по‑прежнему работали после изменений в приложении.
Жизненный цикл задачи: статусы, блокировки и идемпотентность
Раннер задач остаётся надёжным, когда каждая задача следует небольшому, предсказуемому жизненному циклу. Этот цикл — ваша страховка, когда два воркера стартуют одновременно, сервер перезапускается посередине выполнения или нужно повторить без дубликатов.
Небольшой конечный автомат обычно достаточно:
- queued: готова к запуску в
run_at или позже
- running: захвачена воркером
- succeeded: завершена и не должна больше выполняться
- failed: завершена с ошибкой и требует внимания
- canceled: остановлена намеренно (например, пользователь отписался)
Захват задач без двойной работы
Чтобы избежать дублей, захват должен быть атомарным. Обычный подход — блокировка с таймаутом (лиз). Воркер захватывает задачу, устанавливая status=running и записывая locked_by и locked_until. Если воркер падает, лиз истекает и другую задачу может захватить другой воркер.
Практичный набор правил захвата:
- захватывать только queued‑задачи, у которых
run_at <= now
- установить
status, locked_by и locked_until в одном обновлении
- пересекать running‑задачи только когда
locked_until < now
- держать лиз коротким и продлевать его, если задача долгая
Идемпотентность (привычка, которая спасает)
Идемпотентность означает: если одна и та же задача выполнится дважды, результат останется корректным.
Самый простой инструмент — уникальный ключ. Например, для ежедневной сводки можно обеспечить одну задачу на пользователя в день с ключом вроде summary:user123:2026-01-25. Если произойдёт дублирующая вставка, она укажет на ту же задачу, а не создаст вторую.
Отмечайте успех только тогда, когда побочный эффект действительно завершён (письмо отправлено, запись обновлена). Если вы повторяете, путь повторного выполнения не должен создавать второе письмо или дублировать запись.
Повторы и обработка ошибок без драм
Проектируйте надёжные плановые задачи
Создайте процессы планировщика и воркера как Business Processes, которые можно безопастно просматривать и менять.
Именно повторы делают системы задач надёжными или превращают их в шум. Цель проста: повторять, когда ошибка вероятно временная, и останавливаться, когда нет.
Стандартная политика повторов обычно включает:
- максимум попыток (например, 5 попыток всего)
- стратегию задержки (фиксированная задержка или экспоненциальный бэкофф)
- условия остановки (не повторять при ошибках «неверный ввод»)
- джиттер (маленькое случайное смещение, чтобы избежать всплесков повторов)
Вместо изобретения нового статуса для повторов, можно часто переиспользовать queued: установите run_at на время следующей попытки и верните задачу в очередь. Это держит конечный автомат небольшим.
Когда задача может частично продвинуться, относитесь к этому как к норме. Храните контрольную точку, чтобы повторы могли продолжить безопасно — либо в payload задачи (например last_processed_id), либо в связанной таблице.
Пример: задача ежедневной сводки генерирует сообщения для 500 пользователей. Если она падает на 320‑м пользователе, сохраните последний успешно обработанный ID и повторите с 321‑го. Если вы также храните запись summary_sent на пользователя в день, повоторный запуск сможет пропустить уже обработанных пользователей.
Логирование, которое реально помогает
Логируйте достаточно, чтобы отлаживать за считанные минуты:
- id задачи, тип и номер попытки
- ключевые входные данные (user/team id, диапазон дат)
- тайминги (started_at, finished_at, время следующего запуска)
- короткое резюме ошибки (и stack trace, если он есть)
- счётчики побочных эффектов (отправлено писем, обновлено строк)
Пошагово: постройте простой цикл планировщика
Сделайте планирование тестируемым
Тестируйте сценарии «выполнить в 9:00 завтра», вызывая ту же логику задачи по требованию.
Цикл планировщика — небольшой процесс, который просыпается с фиксированным ритмом, смотрит на просроченную работу и передаёт её дальше. Цель — скучная надёжность, а не идеальная точность. Для многих приложений «просыпаться каждую минуту» достаточно.
Выберите частоту пробуждения в зависимости от того, насколько критично время выполнения и сколько нагрузки может выдержать ваша база. Если напоминания должны быть почти в реальном времени, запускайте каждые 30–60 секунд. Если ежедневные сводки могут немного соскользнуть, каждые 5 минут достаточно и дешевле.
Простой цикл:
- Проснуться и взять текущее время (используйте UTC).
- Выбрать просроченные задачи, где
status = 'queued' и run_at <= now.
- Безопасно захватить задачи, чтобы только один воркер их получил.
- Передать каждую захваченную задачу воркеру.
- Заснуть до следующего тика.
Шаг захвата — место, где многие системы ломаются. Вы должны пометить задачу как running (и записать locked_by и locked_until) в той же транзакции, что и её выбор. Многие базы поддерживают чтение с "skip locked", так что несколько планировщиков могут работать без конфликтов.
-- concept example
BEGIN;
SELECT id FROM jobs
WHERE status='queued' AND run_at <= NOW()
ORDER BY run_at
LIMIT 100
FOR UPDATE SKIP LOCKED;
UPDATE jobs
SET status='running', locked_until=NOW() + INTERVAL '5 minutes'
WHERE id IN (...);
COMMIT;
Держите размер батча маленьким (например, 50–200). Большие батчи могут нагрузить базу и сделать падения дороже в восстановлении.
Если планировщик падает посередине батча, лиз спасает вас. Задачи, застрявшие в running, снова становятся доступными после locked_until. Ваш воркер должен быть идемпотентным, чтобы переподнятая задача не создала дублирующие письма или двойные списания.
Паттерны для напоминаний, ежедневных сводок и очистки
Большинство команд в итоге имеют три типа фоновой работы: сообщения, которые должны уйти вовремя, отчёты по расписанию и очистку, которая поддерживает хранилище и производительность. Одна и та же таблица jobs и цикл воркера справятся со всеми ними.
Напоминания
Для напоминаний храните в строке всё, что нужно для отправки сообщения: кому, по какому каналу (email, SMS, Telegram, in‑app), какой шаблон и точное время отправки. Воркер должен уметь выполнить задачу, не "искать вокруг" дополнительный контекст.
Если много напоминаний падает одновременно, добавьте rate limiting. Ограничьте сообщения в минуту по каналу и дайте лишним задачам подождать следующего тика.
Ежедневные сводки
Ежедневные сводки ломаются, когда временное окно нечёткое. Выберите одно стабильное время отсечки (например, 08:00 в локальном времени пользователя) и чётко определите окно (например, «вчера 08:00 — сегодня 08:00»). Храните отсечку и часовой пояс пользователя в задаче, чтобы повторы давали тот же результат.
Держите каждую задачу сводки маленькой. Если нужно обработать тысячи записей, разбейте её на чанки (по команде, по аккаунту или диапазону ID) и поставьте последующие задачи в очередь.
Задачи очистки
Очистка безопаснее, когда вы разделяете «удалить» и «архивировать». Решите, что можно удалить навсегда (временные токены, истёкшие сессии), а что следует архивировать (логи аудита, счета). Запускайте очистку предсказуемыми батчами, чтобы избежать долгих блокировок и резких всплесков нагрузки.
Время и часовые пояса: скрытый источник багов
Отправляйте напоминания безопаснее
Помещайте одноразовые напоминания в очередь с идемпотентными ключами, чтобы снизить дубли и сюрпризы.
Многие сбои — это ошибки времени: напоминание пришло на час раньше, сводка пропустила понедельник или очистка сработала дважды.
Хороший дефолт — хранить расписание в UTC и отдельно хранить часовой пояс пользователя. Ваш run_at должен быть одним UTC‑моментом. Когда пользователь говорит «9:00 по моему времени», конвертируйте это в UTC при планировании.
Переходы на летнее/зимнее время — место, где наивные реализации ломаются. «Каждый день в 9:00» — это не то же самое, что «каждые 24 часа». При переходах 9:00 сопоставляется с разным UTC‑временем, и некоторые локальные времена не существуют (прыжок вперёд) или происходят дважды (откат). Безопаснее вычислять следующее локальное вхождение каждый раз при перепланировании, а затем конвертировать его в UTC.
Для ежедневной сводки заранее решите, что такое «день». Календарный день (с полуночи до полуночи в часовом поясе пользователя) соответствует ожиданиям людей. «Последние 24 часа» проще, но даёт дрейф и сюрпризы.
Поздние данные неизбежны: событие приходит после повтора или заметка добавлена через несколько минут после полуночи. Решите, относятся ли поздние события к «вчера» (с периодом льготы) или к «сегодня», и держите правило единообразным.
Практичный буфер может предотвратить пропуски:
- сканируйте работы с допуском 2–5 минут назад
- делайте задачу идемпотентной, чтобы повторы были безопасны
- записывайте покрываемый временной диапазон в payload, чтобы сводки оставались консистентными
Частые ошибки, которые приводят к пропускам или дублирующим запускам
Большая часть боли исходит из нескольких предсказуемых допущений.
Самое большое — ожидать «ровно один» запуск. В реальных системах воркеры перезапускаются, сетевые вызовы таймаутятся, блокировки теряются. Обычно вы получаете доставку «как минимум один раз», значит дубли — нормальное явление, и ваш код должен к ним быть готов.
Ещё одно — делать эффекты первыми (отправить письмо, снять деньги) без проверки дедупа. Простая защита часто решает проблему: sent_at timestamp, уникальный ключ вроде (user_id, reminder_type, date) или сохранённый токен дедупа.
Следующий разрыв — видимость. Если вы не можете ответить на вопрос «что застряло, с какого времени и почему», вы будете гадать. Минимум данных, которые нужно держать под рукой: статус, счётчик попыток, время следующей попытки, последняя ошибка и id воркера.
Частые ошибки:
- проектировать задачи так, будто они выполняются ровно один раз, а потом удивляться дублирующимся запускам
- делать побочные эффекты без проверки на дубликат
- запускать одну большую задачу, которая пытается сделать всё и попадает в таймаут посередине
- повторять бесконечно без ограничения
- пренебрегать видимостью очереди (нет ясного вида на отставание, ошибки, долгие задачи)
Конкретный пример: задача ежедневной сводки перебирает 50 000 пользователей и таймаутится на 20 000‑м. При повторе она начинает сначала и снова отправляет сводки первым 20 000, если вы не отслеживаете прогресс по пользователям или не разбили задачу на per‑user задачи.
Быстрый чек‑лист для надёжной системы задач
Выпускайте фоновые задачи в прод
Реализуйте паттерн claim–process–update с реальным сгенерированным Go backend-кодом.
Раннер задач «готов», когда вы можете доверять ему в 2 ночи.
Убедитесь, что у вас есть:
- Видимость очереди: счётчики queued vs running vs failed и время самой старой queued‑задачи.
- Идемпотентность по умолчанию: предполагаете, что каждая задача может выполниться дважды; используйте уникальные ключи или маркеры «уже обработано».
- Политика повторов по типу задачи: повторы, бэкофф и чёткое условие остановки.
- Единое хранение времени: держите
run_at в UTC; конвертируйте только при вводе и отображении.
- Восстанавливаемые блокировки: лиз, чтобы падения не оставляли задачи в вечном выполнении.
Также ограничьте batch size (сколько задач вы захватываете за раз) и конкурентность воркеров (сколько одновременно работает). Без ограничений один всплеск может перегрузить базу или забить другие задачи.
Реалистичный пример: напоминания и сводки для небольшой команды
Избегайте технического долга в системах задач
Сохраняйте гибкость, экспортируя или регенерируя чистый исходный код по мере смены требований.
Небольшой SaaS‑инструмент обслуживает 30 аккаунтов. Каждый аккаунт хочет два сценария: напоминание в 9:00 про открытые задачи и ежедневную сводку в 18:00 о том, что поменялось за день. Им также нужна еженедельная очистка, чтобы база не заполнилась старыми логами и истёкшими токенами.
Они используют таблицу jobs и воркер, который опрашивает просроченные задачи. Когда приходит новый клиент, бэкенд планирует первые запуски напоминаний и сводок, исходя из часового пояса клиента.
Задачи создаются в нескольких типичных моментах: при регистрации (создавать повторяющиеся расписания), при определённых событиях (поставить в очередь одноразовые уведомления), при тике расписания (вставить предстоящие запуски) и в день обслуживания (поставить в очередь очистку).
Однажды во вторник почтовый провайдер ушёл в аут на 8:59. Воркер пытается отправить напоминания, получает таймаут и перепланирует эти задачи, устанавливая run_at по бэкоффу (например, 2 минуты, затем 10, затем 30), увеличивая attempts при каждой попытке. Поскольку у каждой задачи‑напоминания есть идемпотентный ключ типа account_id + date + job_type, повторы не приводят к дубликатам, если провайдер восстановится посередине.
Очистка запускается еженедельно малыми батчами, чтобы не блокировать другие работы. Вместо удаления миллиона строк в одном задании, она удаляет до N строк за запуск и перепланирует себя, пока не завершит работу.
Когда клиент жалуется «Мне не пришла сводка», команда смотрит таблицу jobs для этого аккаунта и дня: статус задания, число попыток, текущие поля блокировки и последнюю ошибку от провайдера. Это превращает «должно было отправиться» в «вот что именно случилось».
Следующие шаги: реализуйте, наблюдайте, затем масштабируйте
Выберите один тип задачи и реализуйте его end‑to‑end, прежде чем добавлять остальные. Одна задача‑напоминание — хороший старт, потому что она охватывает всё: планирование, захват просроченной работы, отправку сообщения и запись результатов.
Начните с версии, которой можно доверять:
- создайте таблицу jobs и одного воркера, обрабатывающего один тип задач
- добавьте цикл планировщика, который захватывает и выполняет просроченные задачи
- храните в payload всё, что нужно, чтобы выполнить задачу без догадок
- логируйте каждую попытку и результат, чтобы вопрос «Выполнилось ли?» решался за 10 секунд
- добавьте ручной путь для повторного запуска упавших задач, чтобы восстановление не требовало деплоя
Когда это работает, сделайте систему наблюдаемой для людей. Даже базовый админ‑вью быстро окупается: искать задачи по статусу, фильтровать по времени, смотреть payload, отменять застрявшую задачу, повторно запускать конкретный id.
Если вы предпочитаете строить такой поток планировщика и воркера с визуальной бэкенд‑логикой, AppMaster (appmaster.io) может смоделировать таблицу jobs в PostgreSQL и реализовать цикл claim–process–update как Business Process, при этом генерируя реальный исходный код для деплоя.


 14 июл. 2026 г.
 8 мин